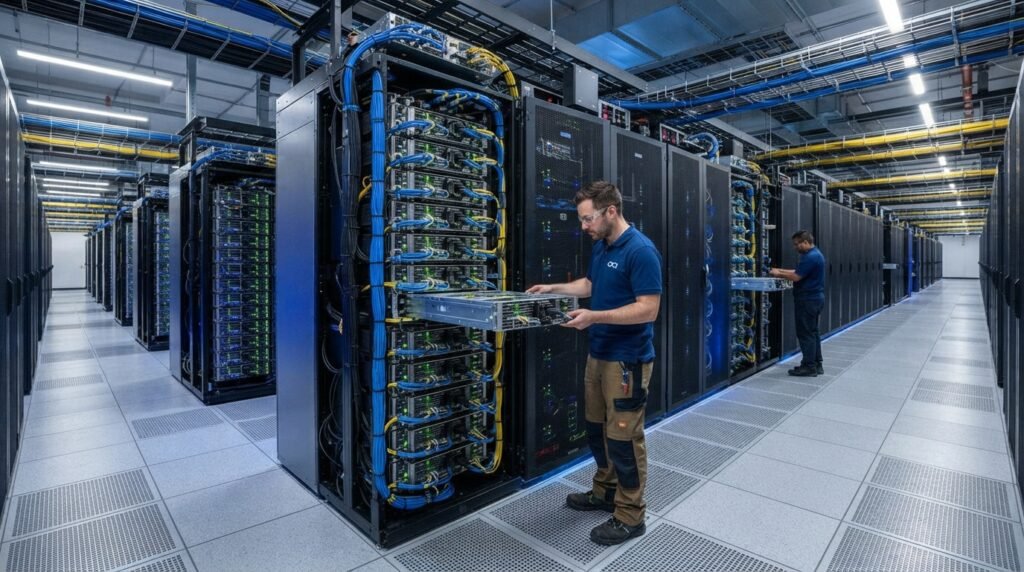
NVIDIAとOracleは、2026年10月27日、Oracle Cloud Infrastructure(OCI)スーパー・クラスターをNVIDIAの次世代「Vera Rubin(ベラ・ルビン)NVL72」ベースのマルチギガワット規模へと大幅に拡張し、「Vera(ベラ)CPU」を正式に搭載したと発表しました。今回のパートナーシップの拡大は、大規模言語モデル(LLM)の高度な学習・推論作業だけでなく、自律型AIエージェント(Agentic AI)がツール実行やデータ収集時に直面するデータ処理のボトルネックを解消し、電力および演算リソースを次元の異なるレベルで拡張することに重点を置いています。
マルチギガワット級OCIスーパー・クラスターとアーキテクチャの統合
NVIDIAとOracleの発表によると、両社はマルチギガワット級の電力および冷却設備を備えたOCIスーパー・クラスター環境に、ラックスケールの演算システムであるVera Rubin NVL72を全面的に構築します。このシステムは、1ラックあたり72基のVera Rubin GPUをNVIDIA NVLink相互接続ネットワークで結合し、強力なコンピューティング性能を提供します。OCIのマルチプラナー(Multiplanar)ネットワークアーキテクチャは、システムの拡張に合わせて数十万基のGPUを高速で接続できるよう支援します。
OCIスーパー・クラスターには、NVIDIA Spectrum-6スイッチとBlueField-4 DPUベースの「NVIDIA Spectrum-X」イーサネットネットワーク技術、そしてOracleのカスタムネットワークインターフェースである「Oracle Acceleron」が統合されました。今回の拡張は、既存のOCIに構築されていたGB200およびGB300 NVL72インフラ技術を継承しており、共通のCUDAソフトウェア基盤を通じて、ハードウェアがアップグレードされても既存のワークロードとの互換性を維持するように設計されています。
自律型AIエージェントの演算支援とVera CPUによるボトルネック解消
両社は今回の発表において、Oracle Cloud Compute環境向けに専用の「NVIDIA Vera CPU」を正式リリース(General Availability)したと明示しました。最新のAIエージェントは、単なる応答生成を超え、外部ツールの呼び出し、コード実行、データベース検索など、CPU集約型のタスクを伴います。従来のインフラでは、こうした演算が鈍化した場合にGPUがモデル呼び出しの合間に待機状態となってしまい、全体的な演算効率が低下するという限界がありました。
Vera CPUは、高いシングルスレッド処理性能と強力なメモリ帯域幅を組み合わせることで、エージェントの複雑なプロセスを迅速に実行できるよう支援します。OCI Kubernetes Engine(OKE)を利用することで、ユーザーはCPUとGPUリソースの拡張規模を個別に調整できるため、リソースの無駄を削減可能です。また、「Oracle Acceleron」ネットワークは、AIが生成した外部コードを実行する際にハードウェアレベルのセキュリティ分離環境を提供することで、セキュリティを強化しました。
x86ベース「HGX Rubin NVL8」の導入と仕様
NVIDIAとOracleは、NVL72ラックスケールに加え、8基のRubin GPUを単一サーバーに搭載するx86アーキテクチャベースの「NVIDIA HGX Rubin NVL8」システムをOCIに順次導入する計画を明らかにしました。このモデルは、高密度ラック構造よりも軽量な8-GPU構成を採用しており、企業が既存のx86互換アプリケーション環境を維持しながら、次世代Rubin GPUを柔軟に導入できるように支援します。
報道資料に記載されたHGX Rubin NVL8の主要システム仕様は以下の通りです。
- 演算アクセラレータ: NVLinkで相互接続された8基のNVIDIA Rubin GPU
- プロセッサおよびメモリ: 64コアのIntel Xeon 6 CPUを2基、および4TBのDDR5システムメモリ
- ネットワーク帯域幅: 6.4Tbpsの超高速RDMA(Remote Direct Memory Access)ネットワークインターフェース
このシステムにより、企業顧客はファインチューニング、フロンティアAIの学習、小規模な推論など、ワークロードの特性に合わせて演算リソースを多様に選択できるようになります。
OpenAI「GPT-6 Astra」による実戦検証と顧客適用
今回の発表では、NVIDIAとOracleのインフラの代表的な実戦導入事例として、グローバルAI研究所であるOpenAIの成果が公開されました。OpenAIは、米国テキサス州アビリーンにあるOCIスーパー・クラスターにて、10万基以上のNVIDIA Blackwell GPUを活用し、次世代フロンティアモデル「GPT-6 Astra(アストラ)」の学習とサービスを実行したと発表しました。
OpenAIのコンピューティングインフラエンジニアリングリーダーであるSreekanth Pothanis氏は、OCIベースのVera Rubinシステムが次世代モデルの厳しいコンピューティング要件を満たす拡張性を提供していると評価しました。また、OpenAIのコンピューティングCTOであるUday Ruddarraju氏は、OCI環境におけるVera CPUのアーリーアクセス(早期アクセス)結果に基づき、急速に増加するエージェント・サンドボックス(Agentic Sandbox)ワークロードのコード実行およびツール運用を処理するため、Vera CPUを本番環境へ投入すると説明しました。
インフラの柔軟性と報道資料に基づく技術的限界
NVIDIAのハイパースケールおよびHPC担当副社長Ian Buck氏と、Oracle OCI社長Mahesh Thiagarajan氏は、AIファクトリーは継続的なソフトウェア最適化と将来のモデル変更に対して柔軟に対応できる耐久性を備えるべきだと強調しました。両社は、Vera Rubin GPUとVera CPU、Oracle Acceleron技術の組み合わせが、GPUの稼働率を最大化し、電力効率を向上させるだろうと付け加えました。
本ニュースは、2026年10月27日にNVIDIAとOracleが提供した単一の報道資料に基づいて作成されており、第三者による独立したインフラ性能検証や詳細な電力消費量の数値は本資料には含まれていません。両社は今後、クラウドの商用化の進行状況に合わせて、詳細な構築スケジュールとリージョン別の普及計画を順次案内する予定です。
公式ソース: